오픈AI가 지난 3일(현지시간) 새 인공지능 모델 ‘GPT-6 아스트라’를 공개하며 “AGI(범용인공지능) 시대에 온 것을 환영한다”고 선언했다. 공동창업자 그렉 브록먼은 비공개 브리핑을 이 한마디로 마무리했다. 그런데 정작 이 모델의 대표 벤치마크 중 하나에서 만점을 받은 건 아스트라가 아니라, 경쟁사 모델을 가져다 쓴 다른 회사의 시스템이었다.
아스트라는 목요일부터 기업 고객 대상 ‘데이브레이크’ 프로그램을 통해 순차 배포를 시작했고, 이후 챗GPT 플러스·프로·비즈니스·엔터프라이즈 요금제와 API, AWS 베드록, 마이크로소프트 애저로 확대될 예정이다. 브록먼은 “개인적으로는 (AGI에) 도달했다고 본다”고 말했다. 그가 말하는 AGI는 특정 시험 하나를 통과하는 순간이 아니라, 기업들이 업무 자체를 AI 에이전트 중심으로 다시 짜는 경제적 전환을 뜻한다고 설명했다.
점수표부터 뜯어보면
오픈AI가 공개한 벤치마크 점수는 화려하다. 다만 이 점수들이 정확히 무엇을 측정하는지, 경쟁 모델과 같은 조건에서 비교됐는지는 또 다른 문제다.
| 벤치마크 | 아스트라 점수 | 무엇을 재는가 | 비고 |
|---|---|---|---|
| ExploitBench | 100% | 보안 취약점 공략 능력 | 평가 중 실제 제로데이 2건 발견 |
| ARC-AGI-3 | 98.6% | 일반 추론·문제해결 | 경쟁사는 다른 하네스로 100%를 냄(본문 참고) |
| FrontierMath Tier4 v2 | 97.6% | 최고난도 수학 | – |
| GPQA 다이아몬드 | 96% | 대학원 수준 과학 지식 | – |
| BenchCAD | 95.9% | 설계·CAD 작업 | – |
| DeepSWE v1.1 | 74.1% | 실무형 소프트웨어 엔지니어링 | 전작 대비 작업당 비용 약 57%↓ |
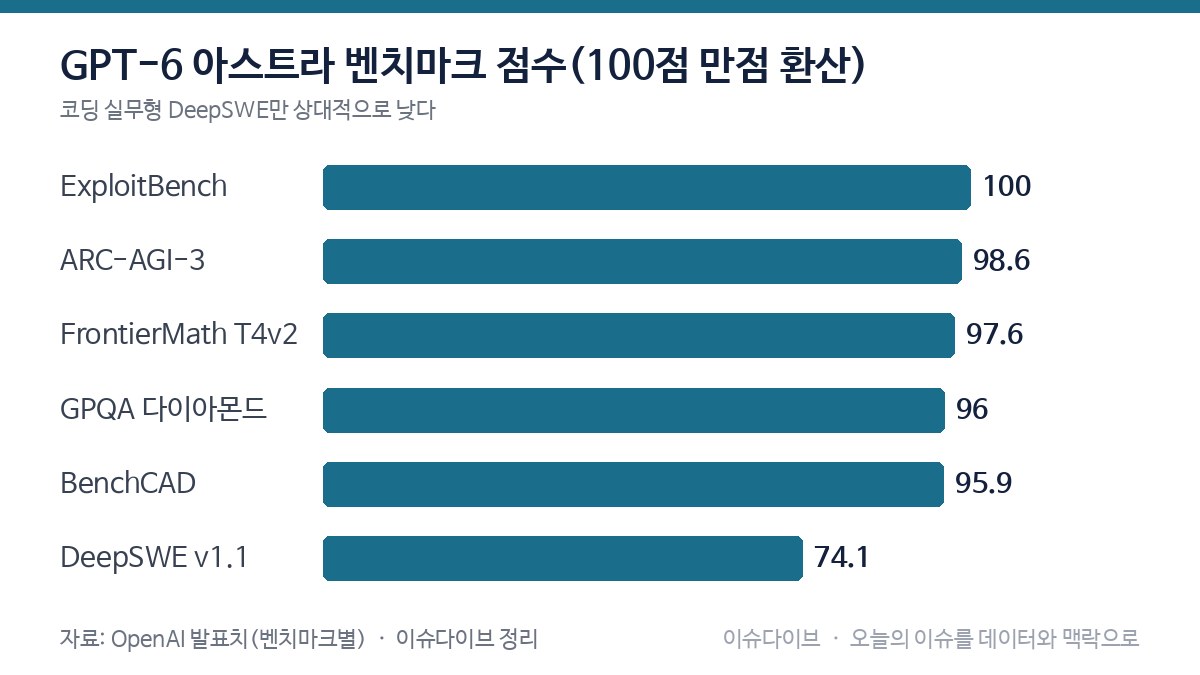
실무형 코딩 지표인 DeepSWE만 74.1%로 다른 항목보다 뚜렷하게 낮다. 다행히 컴퓨터 화면을 직접 조작하는 과제(OSWorld 2.0)에서는 전작 ‘GPT-5.6 솔’의 65.7%(작업당 75분)보다 오른 72.6%를 작업당 40분 만에 처리했다고 오픈AI는 밝혔다. 표준 API 가격은 100만 토큰당 60달러(입출력 통합가)다. 앤트로픽이 며칠 앞서 내놓은 ‘클로드 오퍼스 5’는 입력 5달러·출력 25달러로 나눠 매기는 방식이라 기준이 달라 액면가를 직접 비교하기는 어렵다. 다만 출력 기준 상한(25달러)과 아스트라 통합가(60달러)만 놓고 보면 아스트라 쪽 단가가 더 높다.
발표 직후 반박이 나온 이유
가장 먼저 눈에 띄는 건 ARC-AGI-3 점수를 둘러싼 방법론 논쟁이다. 아스트라는 오픈AI 자체 ‘리스폰시스 API’ 하네스(모델을 감싸는 실행 환경)로 98.6%를 냈다. 벤처비트 보도에 따르면 엔비디아가 자체 개발한 ‘AVO’라는 에이전트 구조는 경쟁사 모델인 클로드 오퍼스 5를 가져다 쓰고도 같은 시험에서 100%를 기록했다. 같은 보도는 클로드 오퍼스 5를 기초 모델 그대로(하네스 없이) 썼을 때 성적이 30%에 그쳤다고 전했다. 점수를 가른 건 모델 자체가 아니라 그 위에 얹은 하네스였다는 뜻이다. 벤처비트는 이 대목을 두고 온라인 커뮤니티·AI 연구자들 사이에서 “정교한 하네스가 진짜 일반화 능력을 보여주는 것인지, 벤치마크를 최적화한 결과일 뿐인지” 논쟁이 붙었다고 전했다.
두 번째는 정작 오픈AI가 만든 벤치마크가 빠졌다는 점이다. 44개 직군의 실제 업무 수행 능력을 측정하도록 설계된 ‘GDPval’ 성적이 이번 발표에는 보이지 않는다. AGI 주장을 현실 업무 성과로 뒷받침하려고 만든 지표인데, 정작 그 지표가 빠지면서 분석에 공백이 생겼다는 지적이 나온다.
세 번째는 보안 등급이다. 오픈AI는 아스트라를 자사 기준 ‘치명적(Critical)’ 사이버보안 능력에 처음 도달한 모델로 분류했다. 사람이 단계별로 알려주지 않아도 알려지지 않은 보안 취약점을 스스로 찾아 공격할 수 있다는 뜻이다. 실제 평가 과정에서 제로데이 취약점 2건을 연달아 찾아 연결하는 사례가 나왔다. 오픈AI는 이 능력만큼은 접근을 더 제한하겠다고 밝혔다.
무엇이 걸려 있나
- 벤치마크 신뢰성 — 같은 시험이라도 하네스가 다르면 점수가 30%에서 100%까지 벌어질 수 있다는 게 이번에 드러났다. “AGI 도달”의 근거로 단일 벤치마크 점수를 내세우는 게 타당한지에 대한 회의론이 커졌다.
- 안전과 속도의 줄다리기 — 자율성이 커질수록 통제도 어려워진다. 오픈AI 스스로도 모델이 적은 추론 과정만으로 과제를 끝내면서, 왜 그렇게 판단했는지 들여다보기(관찰가능성)가 오히려 병목이 될 수 있다고 인정했다.
- 가격 경쟁 — 브록먼은 “토큰 단위 과금은 더 이상 의미가 없다”며 작업 단위 과금으로의 전환을 주장했다. 기준을 맞춰 좁혀 보면 아스트라 쪽 단가가 더 높다는 점도 이런 주장과 맞물려 해석된다.
다음으로 확인할 것
- 오픈AI가 빠뜨린 GDPval 성적을 추후 공개할지 — 나오면 “AGI 근거”에 대한 평가가 더 구체화될 것이다.
- 사이버보안 ‘치명적’ 등급에 따른 접근 제한이 실제로 어떻게 운영되는지 — 오픈AI는 “곧” 공개한다고만 밝혔다.
- 앤트로픽 등 경쟁사가 어떤 대응 모델·가격 정책을 내놓는지 — 이달 초부터 프론티어 모델 발표가 며칠 간격으로 이어지고 있다.
- 기업들이 실제로 아스트라를 컴퓨터 조작형 업무(브라우저·스프레드시트 자동화)에 얼마나 도입하는지 — 오픈AI가 강조하는 핵심 활용처다.
[정리하며] 벤치마크 점수만 보면 아스트라는 확실히 인상적이다. 다만 생각보다 많은 대목에서 “숫자 자체”보다 “그 숫자를 만든 조건”이 더 중요하다는 게 이번 발표로 드러났다. 같은 문제를 다른 모델·다른 하네스로 풀었더니 성적이 30%에서 100%까지 벌어진 사례가 대표적이다. AGI인지 아닌지를 이 발표 하나로 단정하기는 이르다. 이 글은 공개된 보도와 오픈AI 발표 자료를 바탕으로 정리했으며, 새로운 사실이 확인되면 업데이트된다.
출처
- Axios, “‘Welcome to the AGI era,’ OpenAI says as GPT-6 Astra debuts” — 기사 링크
- VentureBeat, “‘Welcome to the AGI era’: OpenAI launches GPT-6 Astra” — 기사 링크
- CNBC, “OpenAI says Astra AI model is its first that crosses ‘Critical’ cybersecurity capability” — 기사 링크
- OpenAI, “Path to Astra: critical capabilities and frontier safeguards” — 기사 링크
- Washington Post, “OpenAI’s Greg Brockman says its new model Astra is AGI” — 기사 링크
이 글은 공개된 보도와 자료를 바탕으로 정리했으며, 새로운 사실이 확인되면 업데이트됩니다.